
Trong bài viết này, mình sẽ giới thiệu về các cấu trúc dữ liệu, kèm theo ví dụ minh họa cho từng cấu trúc và cách chúng được biểu diễn trong Memgraph. Trong các cấu trúc này, đồ thị nổi bật như một cấu trúc dữ liệu phi tuyến tính bao gồm một tập hợp hữu hạn các nút, được kết nối bởi các mối quan hệ. Đồ thị thường được ứng dụng để giải quyết các vấn đề thực tế trong các lĩnh vực như mạng, đồ thị tri thức hoặc các trường hợp phát hiện gian lận.
Hãy xem qua bảng tham khảo nhanh Data Structures Cheat Sheet để nắm tổng quan về các cấu trúc mà mình sẽ đề cập dưới đây.
Đồ thị là gì?
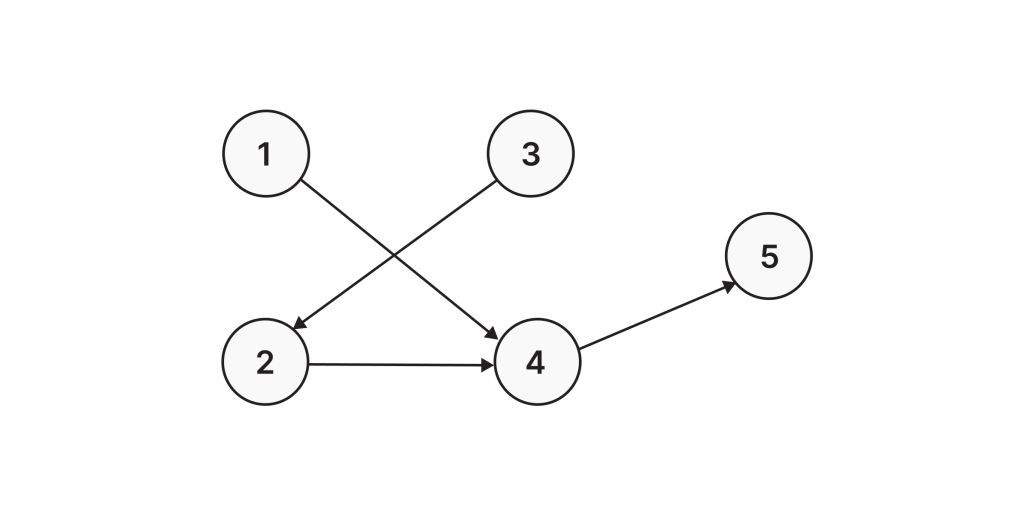
Để bước vào thế giới cấu trúc dữ liệu, trước tiên chúng ta cần hiểu những khái niệm cơ bản. Như đã đề cập, đồ thị là một cấu trúc dữ liệu bao gồm các nút (đỉnh) và các mối quan hệ (cạnh). Các mối quan hệ kết nối bất kỳ hai nút nào trong đồ thị, và mỗi nút có thể lưu trữ các thuộc tính khác nhau. Ở hình dưới, ta thấy một đồ thị gồm năm nút được kết nối bằng các mối quan hệ có hướng.
Tạo nút và mối quan hệ
Giờ hãy tạo đồ thị trong hình minh họa trên bằng Memgraph. Đảm bảo rằng bạn đã có một phiên bản Memgraph đang chạy. Nếu chưa cài đặt, bạn có thể tham khảo hướng dẫn cài đặt trong tài liệu của Memgraph. Cách nhanh nhất để trải nghiệm Memgraph Platform (bao gồm cơ sở dữ liệu Memgraph, thư viện MAGE và Memgraph Lab) là chạy một trong các lệnh sau với Docker:
- Trên Linux/macOS:
curl https://install.memgraph.com | sh- Trên Windows:
iwr https://windows.memgraph.com | iexTừ hình trên, ta thấy có năm nút, mỗi nút được đánh dấu bởi một số. Hãy tạo các nút với nhãn là Node và các số là thuộc tính name trong các nút đó, kèm theo mối quan hệ có hướng :TO giữa chúng:
CREATE (n1:Node {name: '1'}), (n2:Node {name: '2'}),
(n3:Node {name: '3'}), (n4:Node {name: '4'}), (n5:Node {name: '5'}),
(n1)-[:TO]->(n4), (n3)-[:TO]->(n2),
(n2)-[:TO]->(n4), (n4)-[:TO]->(n5)
Nếu bạn sử dụng giao diện trực quan của Memgraph là Memgraph Lab, bạn có thể xem đồ thị vừa tạo bằng cách chạy lệnh:
MATCH p=(()-[]-()) RETURN p;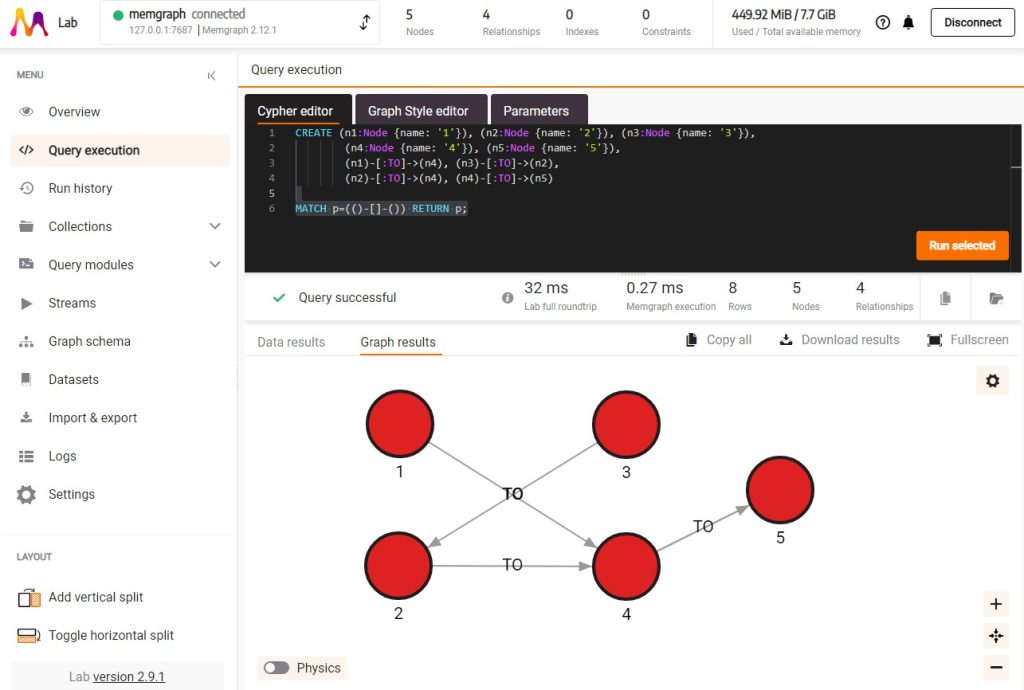
Tạo chỉ mục
Giống như các hàm băm có chỉ mục, Memgraph cũng hỗ trợ tạo chỉ mục trên một số kết hợp giữa nhãn Node hoặc Node+Property để quét qua cơ sở dữ liệu và truy xuất nút nhanh hơn khi có một tập dữ liệu lớn. Ví dụ, nếu có nhiều nhãn khác nhau và một tập dữ liệu lớn, bạn có thể tạo chỉ mục trên nhãn Node bằng cách:
CREATE INDEX ON :NodeCấu trúc dữ liệu
Trong khoa học máy tính, cấu trúc dữ liệu là cách tổ chức, quản lý và lưu trữ dữ liệu nhằm truy cập dữ liệu hiệu quả hơn. Nói cụ thể hơn, một cấu trúc dữ liệu là tập hợp các giá trị dữ liệu, các mối quan hệ giữa chúng, và các hàm hoặc thao tác có thể áp dụng lên dữ liệu. Có nhiều loại cấu trúc dữ liệu khác nhau, và trong bài viết này, mình sẽ đề cập đến Danh sách liên kết, Ma trận, Hàng đợi, Ngăn xếp và Cấu trúc cây.
Danh sách liên kết
Danh sách liên kết là một cấu trúc dữ liệu tuyến tính, trong đó các phần tử không được lưu trữ tại vị trí liên tiếp mà được liên kết thông qua các con trỏ. Nó tổ chức các mục theo thứ tự, với mỗi mục chứa một con trỏ đến mục tiếp theo. Một mục trong danh sách liên kết được gọi là nút. Nút đầu tiên gọi là “head” và nút cuối gọi là “tail.”

Biểu diễn Danh sách liên kết trong Memgraph
Tương tự như vậy, trong Memgraph, mình cũng sẽ biểu diễn các mục trong danh sách liên kết bằng các nút, nhưng mình không cần lưu trữ thông tin về địa chỉ của nút tiếp theo, mà chỉ cần sử dụng đồ thị có hướng để thực hiện điều đó. Hãy tạo lại danh sách liên kết từ hình minh họa bên trên, với mối quan hệ là LINKED_TO:
CREATE (n1:Node {name: 'A'}), (n2:Node {name: 'B'}), (n3:Node {name: 'C'}), (n4:Node {name: 'D'}),
(n1)-[:LINKED_TO]->(n2)-[:LINKED_TO]->(n3)-[:LINKED_TO]->(n4)
Ngoài ra, bạn có thể lưu trữ các thuộc tính khác bên trong các nút của mình, như IDcode, tên khác của các nút hoặc bất kỳ thông tin bổ sung nào khác.
Khi chạy truy vấn sau, chúng ta có thể trực quan hóa dữ liệu đã tạo và dễ dàng truy cập vào các thuộc tính của nó bằng cách nhấp vào một nút cụ thể:
MATCH p=(()-[]-()) RETURN p;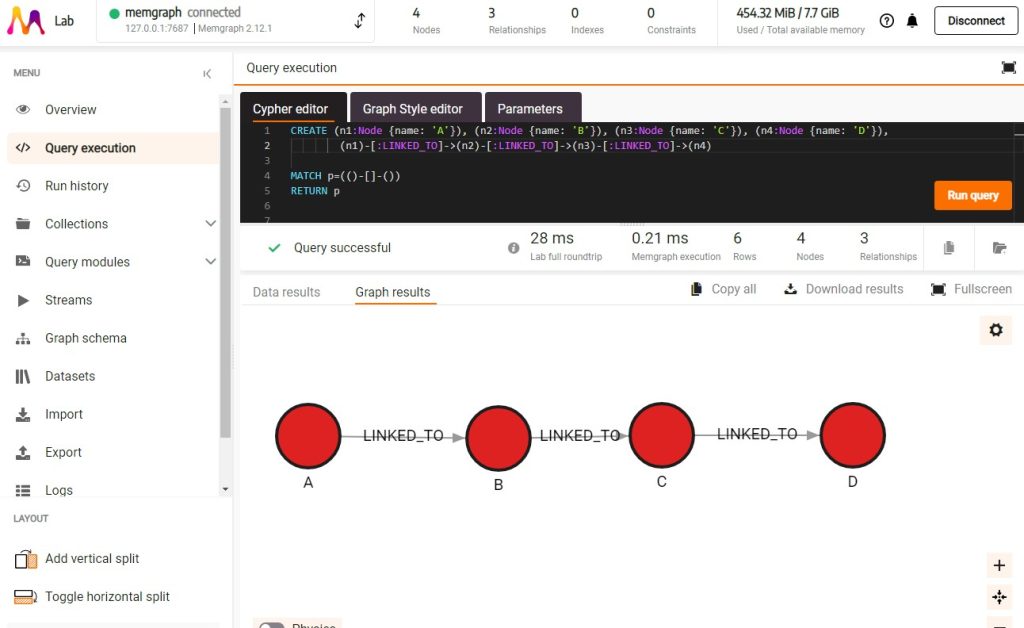
Nếu bạn có một đồ thị lớn hơn và muốn, ví dụ, lấy thông tin về nơi mà nút có tên C liên kết tới, bạn có thể dùng truy vấn sau:
MATCH (:Node {name: 'C'})-[:LINKED_TO]->(m)
RETURN m;
Hàng đợi
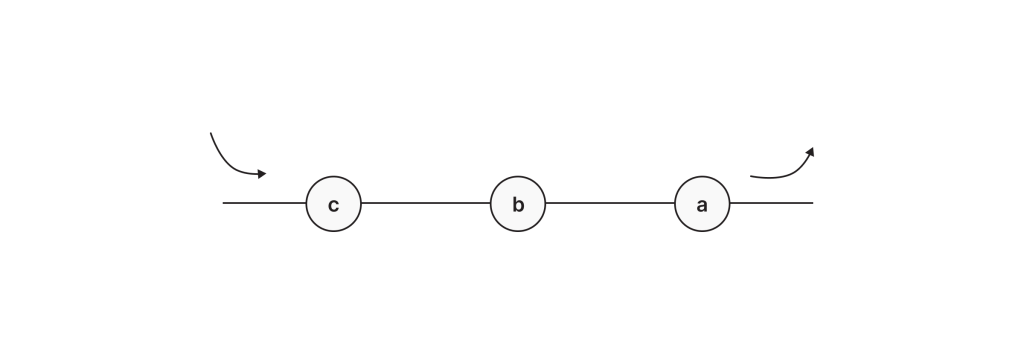
Hàng đợi là một cấu trúc dữ liệu tuyến tính mở ở cả hai đầu và các thao tác được thực hiện theo thứ tự vào trước ra trước (FIFO).
Chúng ta định nghĩa hàng đợi là một danh sách trong đó tất cả các bổ sung vào danh sách đều được thực hiện ở một đầu và tất cả các thao tác xóa khỏi danh sách đều được thực hiện ở đầu kia. Phần tử nào được thêm vào hàng đợi trước, thao tác sẽ được thực hiện trên nó trước.
Biểu diễn Hàng đợi trong Memgraph
Trong Memgraph, mình có thể biểu diễn một hàng đợi bằng cách tạo các nút và kết nối chúng với mối quan hệ chỉ ra nút nào đến trước với mối quan hệ :BEFORE. Tương tự, mình cũng có thể tạo mối quan hệ :AFTER và định hướng các mối quan hệ theo chiều ngược lại, tùy thuộc vào điều gì phù hợp nhất.
Truy vấn sau tạo ra ba nút và mối quan hệ :BEFORE giữa chúng, chỉ ra rằng nút A “đến hàng đợi” trước, sau đó là các nút B và C:
CREATE (n1:Node {name: 'A'}), (n2:Node {name: 'B'}), (n3:Node {name: 'C'}),
(n1)-[:BEFORE]->(n2)-[:BEFORE]->(n3);
Các thao tác với Hàng đợi
Nếu muốn tìm phần tử nào ở đầu hàng đợi và loại bỏ nó, giống như chức năng Dequeue(), mình có thể thực hiện với truy vấn sau:
MATCH (a)-[:AFTER]->(b)
WHERE NOT exists((b)-[:AFTER]->())
RETURN b;
Tương tự, nếu muốn thêm một phần tử D vào cuối hàng đợi, giả lập chức năng Enqueue():
MATCH (a)-[:AFTER]->(b)
WHERE NOT exists(()-[:AFTER]->(a))
CREATE (n4:Node {name: ‘D’})-[:AFTER]->(a);
Ngăn xếp (Stack)
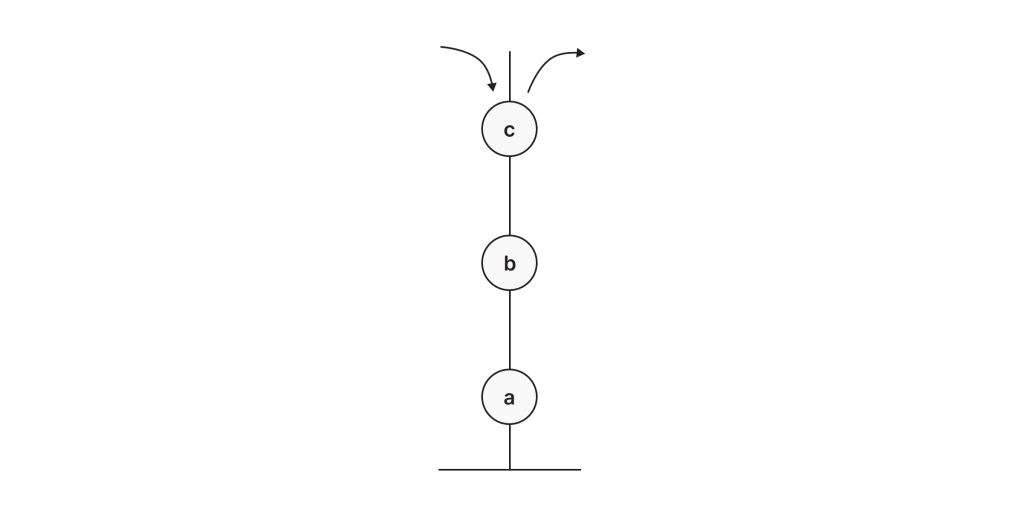
Ngăn xếp là một cấu trúc dữ liệu tuyến tính theo một thứ tự đặc biệt khi thực hiện các thao tác. Thứ tự này có thể là LIFO (Last In First Out – vào sau ra trước) hoặc FILO (First In Last Out – vào trước ra sau). Với LIFO, phần tử được thêm vào cuối cùng sẽ là phần tử đầu tiên được lấy ra. Với FILO, phần tử đầu tiên được thêm vào sẽ là phần tử cuối cùng được lấy ra.
Biểu diễn Ngăn xếp trong Memgraph
Trong Memgraph, mình có thể biểu diễn ngăn xếp tương tự như cách biểu diễn hàng đợi. Truy vấn sau tạo ra các nút và mối quan hệ :ON_TOP giữa chúng, cho thấy rằng nút A vào ngăn xếp đầu tiên, tiếp theo là các nút B và C. Vì ngăn xếp hoạt động theo nguyên tắc First In Last Out, ta chỉ có thể truy cập nút vào cuối cùng, trong trường hợp này là nút C.
CREATE (n1:Node {name: 'A'}), (n2:Node {name: 'B'}), (n3:Node {name: 'C'}),
(n3)-[:ON_TOP]->(n2)-[:ON_TOP]->(n1)
Các thao tác với Ngăn xếp
- Pop: Để lấy phần tử ở đầu ngăn xếp và xóa nó, tương tự như hàm
Pop(), ta có thể dùng truy vấn sau:MATCH (a)-[:ON_TOP]->(b) WHERE NOT exists(()-[:ON_TOP]->(a)) DETACH DELETE aTruy vấn này trước tiên khớp với tất cả các nút trên một nút khác và lọc ra nút không có nút nào ở trên cùng, tức là nút đang ở đầu ngăn xếp. - Push: Để thêm một nút mới vào ngăn xếp, tương tự như hàm
Push(), ta có thể thực hiện truy vấn sau:MATCH (a)-[:ON_TOP]->(b) WHERE NOT exists(()-[:ON_TOP]->(a)) CREATE (n4:Node {name:'D'})-[:ON_TOP]->(a)Tương tự như truy vấn trước, ta lấy nút ở đầu ngăn xếp rồi tạo nút mới, kết nối với nút đó bằng mối quan hệ:ON_TOP.
Cấu trúc cây
Cây tổ chức các giá trị theo thứ bậc. Mỗi mục trong cây được gọi là một nút và mỗi nút có thể liên kết tới 0 hoặc nhiều nút con. Các nút lá là những nút ở cuối cây (nói cách khác: các nút không có con). Mỗi nút trong cây có độ sâu: số mối quan hệ từ gốc tới nút đó. Chiều cao của cây là số mối quan hệ từ gốc đến nút lá xa nhất (tức là độ sâu lớn nhất của nút).

Cách biểu diễn Cấu trúc cây trong Memgraph
Memgraph đã có cấu trúc tương tự với cây, bao gồm các nút được kết nối với nhau bằng các mối quan hệ, chỉ cần chỉ định kết nối giữa các nút để xác định nút cha và nút con.
Để tạo cây giống như hình minh họa trên, ta có thể chạy truy vấn sau, tạo ra các nút từ A đến I với mối quan hệ :PARENT_OF để chỉ ra kết nối.
CREATE (n1:Node {name: 'A'}), (n2:Node {name: 'B'}), (n3:Node {name: 'C'}), (n4:Node {name: 'D'}),
(n5:Node {name: 'E'}), (n6:Node {name: 'F'}), (n7:Node {name: 'G'}), (n8:Node {name: 'H'}), (n9:Node {name: 'I'}),
(n1)-[:PARENT_OF]->(n2)-[:PARENT_OF]->(n4), (n2)-[:PARENT_OF]->(n5)-[:PARENT_OF]->(n8),
(n5)-[:PARENT_OF]->(n9), (n1)-[:PARENT_OF]->(n3)-[:PARENT_OF]->(n6), (n3)-[:PARENT_OF]->(n7)
Sau khi chạy truy vấn này, chúng ta sẽ có thể trực quan hóa cấu trúc cây mới tạo trong Memgraph.
MATCH p=(()-[]-()) RETURN p;
Duyệt cây (Tree Traversal)
Trong khoa học máy tính, duyệt cây (còn được gọi là tìm kiếm cây) là quá trình ghé thăm từng nút trong cấu trúc dữ liệu cây đúng một lần để truy xuất, cập nhật hoặc xóa. Các phương pháp duyệt cây được phân loại dựa trên thứ tự ghé thăm các nút. Hai thuật toán phổ biến nhất cho duyệt cây là Duyệt theo chiều rộng (Breadth-First Search, BFS) và Duyệt theo chiều sâu (Depth-First Search, DFS).
Thuật toán Duyệt theo Chiều Rộng (BFS)
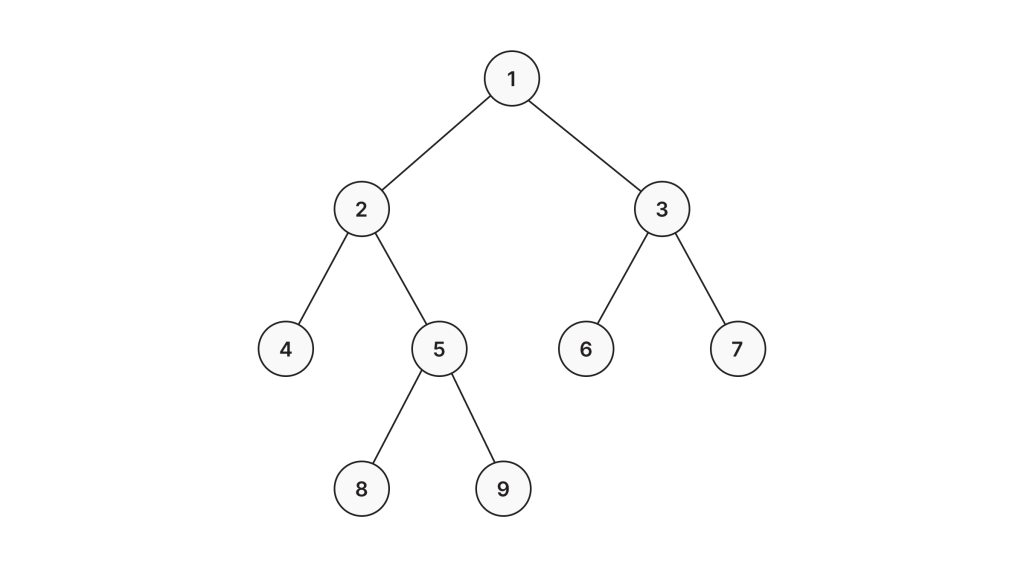
Trong duyệt theo chiều rộng, BFS bắt đầu từ một nút duy nhất, và thứ tự của các nút được ghé thăm phụ thuộc vào độ rộng của các nút (tức là khoảng cách từ nút nguồn). Điều này có nghĩa là khi một nút nào đó được ghé thăm, tất cả các nút ở khoảng cách gần hơn từ nút nguồn đã được ghé thăm trước, giúp xác định đường đi ngắn nhất từ nút nguồn đến nút vừa ghé thăm.
Ví dụ, với cây mẫu, các nút được gán nhãn theo thứ tự BFS như hình bên dưới:
Thực thi BFS trong Memgraph
Trong Memgraph, BFS được triển khai dựa trên cú pháp mở rộng mối quan hệ, có một số lợi ích so với hàm chuyên biệt. Cú pháp này cho phép lọc nút và mối quan hệ ngay trên đường đi, tìm nhiều đường đến nhiều nút đích, và duyệt qua vùng lân cận của một nút theo thứ tự BFS.
Truy vấn sau đây sẽ hiển thị đường đi ngắn nhất giữa các nút A và H:
MATCH path=(a {name: 'A'})-[*BFS]->(h {name: 'H'})
RETURN path;
Để lấy danh sách các mối quan hệ, thêm biến trước *BFS và trả về kết quả:
MATCH (a {name: 'A'})-[relationships *BFS]->(h {name: 'H'})
RETURN relationships;
Thuật toán Duyệt theo Chiều Sâu (DFS)
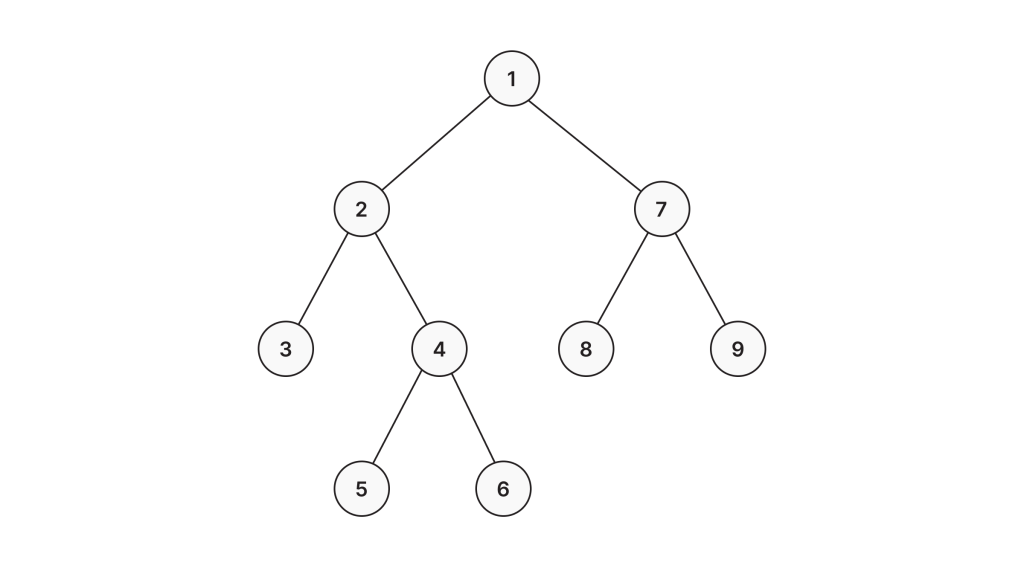
DFS là một thuật toán duyệt cây bằng cách khám phá các nút lân cận càng xa càng tốt. Khi đạt đến điểm cuối (dead-end), thuật toán sẽ quay lại tìm một nút mới chưa được khám phá, sau đó tiếp tục duyệt từ nút này để tìm các nút chưa được khám phá. Theo cách này, thuật toán duyệt qua tất cả các nút trong cây.
Ví dụ, DFS sẽ duyệt qua cây mẫu như hình bên dưới:
Thực thi DFS trong Memgraph
DFS trong Memgraph cũng được triển khai dựa trên cú pháp mở rộng mối quan hệ, cho phép tìm nhiều mối quan hệ giữa hai nút nếu tồn tại.
Truy vấn sau đây hiển thị tất cả các đường đi từ nút A đến nút H:
MATCH path=(a {name: 'A'})-[*]->(h {name: 'H'})
RETURN path;
Để lấy danh sách tất cả các mối quan hệ, thêm biến trong dấu ngoặc vuông và trả về kết quả:
MATCH (a {name: 'A'})-[relationships *]->(h {name: 'H'})
RETURN relationships;
Duyệt cây theo BFS và DFS trong Memgraph cho phép trực quan hóa cấu trúc và tính liên kết của các nút một cách hiệu quả, đặc biệt khi phân tích dữ liệu lớn và tìm kiếm đường đi trong các cấu trúc cây phức tạp.